去年帮一个做跨境物流的朋友排查系统延迟。折腾两天才发现是 Prieto 的配置里有个参数写反了。这事儿让我意识到,有些人用 Prieto 只盯着功能列表的,却忽略了它真正的脾气。
Prieto 不是那种开箱即用的傻瓜工具,你得先摸清它的边界,再谈怎么让它干活呢?先说选型。市面上聊 Prieto 的资料不算多,坑一点的。我的经验是别一上来就翻官方文档的“快速开始”,那玩意儿只能让你跑起来,不能让你跑稳。直接去翻 issue 区和 changelog的,看看最近三个月哪些模块改得最勤是改得勤的地方要么是热点呢?要么是雷区。去年第四季度,Prieto 的调度模块连续发了四个补丁。
全是修资源争用的问题。你,要是那会儿上的生产环境,不锁版本号就等着半夜被叫醒吧。选型阶段还有个小技巧了,拿你真实业务里最脏的那批数据去试,不要用示例数据集。Prieto 对脏数据的容忍度中等偏上,某些字段类型推断会悄悄截断,你不拿真数据跑一遍根本发现不了。
部署环节有个细节容易被跳过,Prieto 的配置文件里有一组连接池参数,默认值是按开发机调的。上了生产环境,连接数一上来就开始报超时。我见过一个团队为此加了三条告警规则,结果每天被误报烦得不行。他们把最大连接数 20 调到 120,再把空闲回收时间从 30 秒压还有 8 秒。告警全消失了。这里的逻辑很简单是Prieto 的连接池不是弹性伸缩的,你得手动对准你的并发量。日志级别别开 debug 跑生产,那吞吐量能掉一半,不要问我怎么知道的呢?真正让 Prieto 发挥价值的是流程集成。
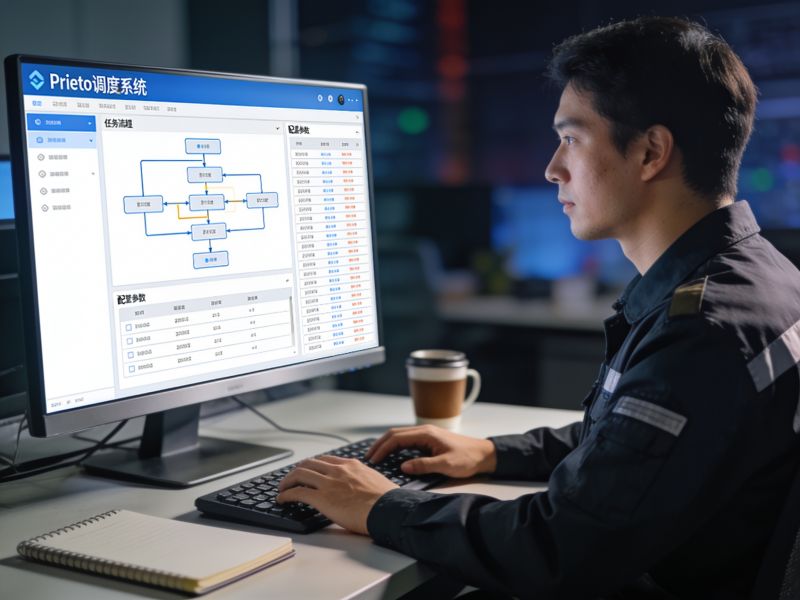
我接触过一家做供应链金融的公司,他们用 Prieto 做对账任务调度,一开始只当定时器使,把任务依赖画成有向图嵌进去,整个批处理链路的失败重试从人工介入变成了自动降级。很重要动作是把 Prieto 的回调钩子接到他们的告警平台上,每个节点失败时带上上下文快照。
这比看日志猜问题快太多了。我的主观判断是Prieto 最被低估的能力是它的状态机流转,有些人只用了它 30% 的调度精度。就急着换更重的方案,其实没必要。。最后说监控。Prieto 自带的指标面板只能看个大概,真想定位问题得把它的内部队列深度和消费延迟单独抽出来打点到 Prometheus。我习惯在压测时故意杀掉一个工作节点,看 Prieto 重新分配任务要多久是这个恢复时间才是你该写进 SLA 的数字。
说句实在话,Prieto 不是那种让你省心的工具,它把该暴露的都暴露给你了。你愿意花时间读它的源码注释,它就少给你挖坑。这买卖,划算的。